StudentSim test AI-tutoren vóór ze de klas ingaan
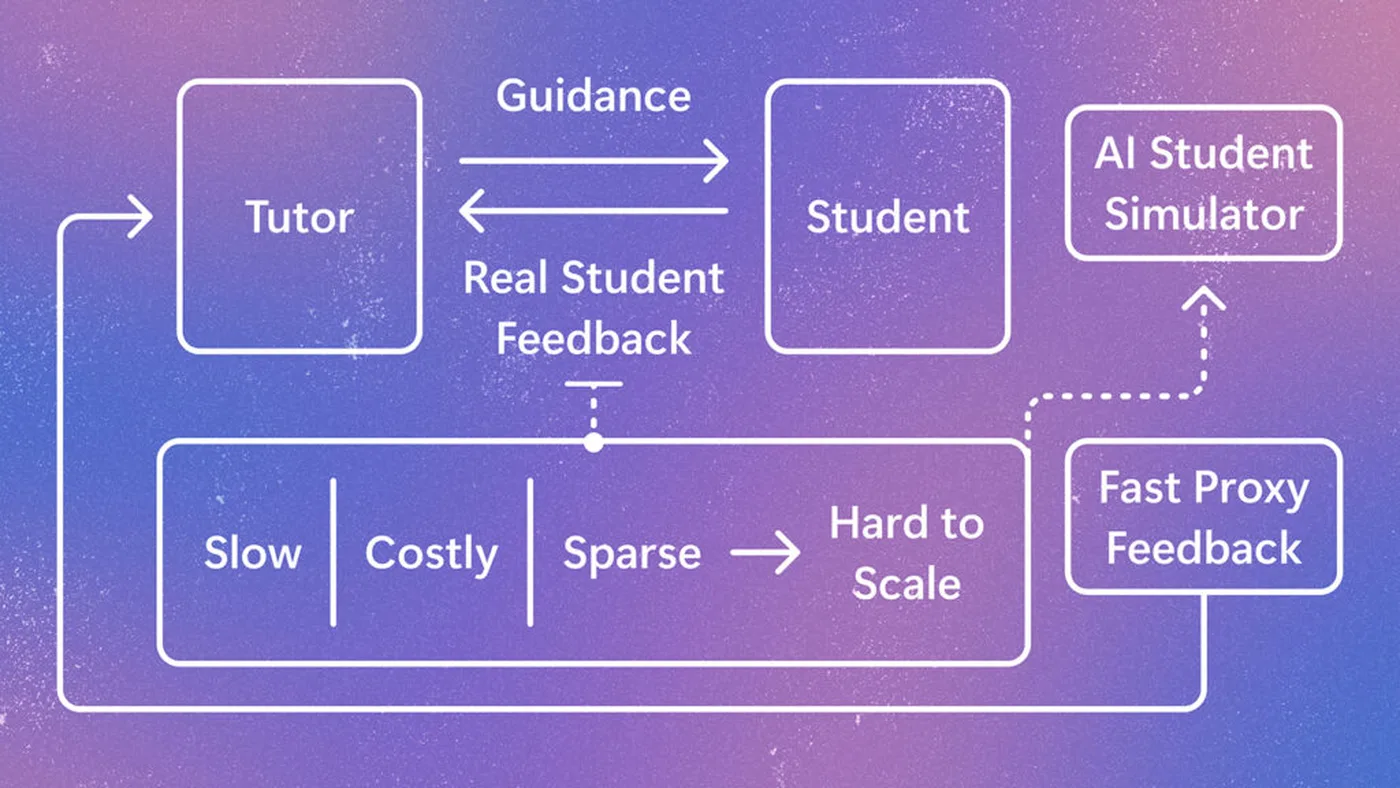
Microsoft Research heeft StudentSim gepresenteerd, een onderzoeksprototype dat het gedrag van afzonderlijke leerlingen simuleert. Onderzoekers kunnen daarmee feedback op een AI-tutor testen voordat zij die tutor met echte leerlingen onderzoeken.
Voor scholen en opleidingen is vooral de grens belangrijk: StudentSim is geen klasproduct en bewijst geen leerwinst. Het onderzoek laat wel zien hoe ontwikkelaars AI-tutoren gerichter kunnen testen op passend uitleggen, fouten herkennen en reageren op verschillende leerlingen.
Wat er nieuw is
Microsoft Research publiceerde het onderzoek op 12 oktober 2026. StudentSim maakt voor iedere leerling een afzonderlijke simulator op basis van openbare, voor onderzoek vrijgegeven en gedeïdentificeerde leergegevens. Eerst leert het systeem algemene patronen uit gegevens van meerdere leerlingen; daarna wordt het aangepast aan de beperkte gegevens van één leerling.
De onderzoekers beoordelen de simulator langs twee onderwijsinhoudelijke dimensies. Behavioral fidelity meet of een simulator antwoorden en fouten van een specifieke leerling kan benaderen. Guidance responsiveness meet of de simulatie na uitleg of een hint op een vergelijkbare manier verandert. De evaluatie omvat schaken, schrijven in het Engels als tweede taal en wiskunde.
StudentSim presteerde in de gerapporteerde proeven beter dan de gebruikte baselines. In een proof-of-concept met een schaaktutor kreeg de tutor die met StudentSim-feedback was getraind van menselijke schaakexperts de hoogste beoordeling. Dat is een onderzoeksresultaat binnen een afgebakende opzet, geen bewijs dat dezelfde methode in een Nederlandse of Belgische klas werkt.
De kans: eerder zwakke tutoren ontdekken
Een AI-tutor kan een correct antwoord geven en toch slecht lesgeven. Een hint kan te veel verklappen, een uitleg kan boven het niveau van een leerling liggen en een systeem kan hardnekkige fouten missen. StudentSim probeert juist zichtbaar te maken wat er ná de uitleg gebeurt: corrigeert de gesimuleerde leerling de fout en past de ondersteuning bij diens beginsituatie?
Voor ontwikkelaars van educatieve AI kan zo'n simulatie een extra testlaag zijn. Verschillende uitlegstrategieën kunnen sneller worden vergeleken voordat leerlingen eraan worden blootgesteld. Leraren, onderzoekers en leveranciers kunnen daardoor eerder vragen stellen over dosering van hints, hardnekkige misconcepties en verschillen tussen leerlingen.
De methode kan echte gebruikstesten niet vervangen. Een simulator ervaart geen motivatie, schaamte, groepsdruk, vermoeidheid of relatie met een docent zoals een leerling dat doet. Ook een goede overeenkomst met historische antwoorden zegt nog niet dat een hulpmiddel veilig, begrijpelijk of leerzaam is in de praktijk.
Privacy en profilering vragen harde grenzen
Het onderzoek gebruikt volgens Microsoft alleen openbare, gedeïdentificeerde onderzoeksdata en geen direct identificerende informatie. Een toepassing met actuele leerlinggegevens zou veel zwaardere vragen oproepen. Een individueel gedragsmodel kan immers patronen vastleggen over fouten, taalniveau en reactie op begeleiding.
Onderwijsinstellingen moeten voorkomen dat een experimentele simulatie verandert in een permanent leerlingprofiel. Leg vooraf doel, minimale gegevens, bewaartermijn, toegang en verwijdering vast. Gebruik zulke modellen niet voor cijfers, toelating, doorstroom, zorgbesluiten of disciplinaire maatregelen. De uitkomst blijft een voorspelling, geen digitale kopie van een leerling.
Gevolgen voor toetsing en toegankelijkheid
Een tutor die sterker wordt in persoonlijke hints kan oefenen toegankelijker maken, bijvoorbeeld door uitleg in kleinere stappen te geven. Tegelijk kan vergaande personalisatie verschillen onzichtbaar maken: de ene leerling krijgt mogelijk meer sturing dan de andere. Bij beoordeeld werk moet daarom duidelijk zijn welke hulp beschikbaar was en welk begrip de leerling zelfstandig kan tonen.
Test bovendien met verschillende talen, ondersteuningsbehoeften en apparaten. De drie onderzochte domeinen zijn niet representatief voor alle schoolvakken of leerlinggroepen. Prestaties in Engelstalige onderzoeksdatasets kunnen niet zonder meer worden vertaald naar Nederlandstalig en meertalig onderwijs.
Wat teams nu kunnen afspreken
- Vraag leveranciers hoe zij de didactische kwaliteit van een AI-tutor testen, niet alleen de juistheid van antwoorden.
- Eis daarna proeven met echte leerlingen, docenten en representatieve onderwijscontexten voordat een tutor breed wordt ingezet.
- Gebruik alleen minimale, rechtmatig verkregen leerlinggegevens en voorkom permanente individuele gedragsprofielen.
- Laat leraren bepalen welke hints passen bij leerdoelen en wanneer een leerling zonder AI moet oefenen of presteren.
- Meet naast tevredenheid ook begrip, zelfstandigheid, transfer, toegankelijkheid en onbedoelde verschillen tussen leerlingen.
- Gebruik simulatoruitkomsten nooit als zelfstandig bewijs voor beoordeling of beslissingen over een leerling.
De kern
StudentSim laat zien dat een AI-tutor niet alleen op mooie antwoorden moet worden getest, maar ook op wat zijn uitleg bij verschillende leerlingen teweegbrengt. Leerlingsimulaties kunnen daarbij een vroege testlaag zijn. Echte leerlingen, menselijke beoordeling en onderzoek naar daadwerkelijke leeruitkomsten blijven onmisbaar.